La nova versió QiliSDK 0.3.1 millora l'execució multigpu amb un motor de renderització basat en NVIDIA CUDA-Q. Qualsevol emulació que ja no s'ajusti a la memòria d'una GPU ara es pot distribuir a totes les GPU d'un node, sense cap canvi en el codi de l'usuari. Es va realitzar una prova de rendiment en un node amb quatre GPU NVIDIA RTX PRO 6000 NVIDIA Blackwell, permetent l'emulació de circuits aleatoris de 34 qubits, dos qubits més del que una sola GPU pot contenir, i executar-los aproximadament cinc vegades més ràpidament que amb el simulador de CPU QiliSim, superant els colls d'ampolla de la CPU.
Informàtica quàntica multimodal a Qilimanjaro
Els sistemes de Qilimanjaro funcionen dins de centres europeus de HPC i a través de Qilimanjaro Speqtrum® seguint un enfocament multimodal: processadors quàntics analògics i digitals que funcionen juntament amb CPUs i GPUs, en el mateix espai i sota el mateix programari.
Aquesta aproximació multimodal també dota les qüestions que tracta Qilimanjaro: quina infraestructura de computació quàntica a escala industrial cal, com conflueixen la IA, el HPC i el processament quàntic en una mateixa instal·lació, i què necessita un ecosistema quàntic europeu més fort i més sobirà sota d’això.
Per als usuaris, el programari és el que fa que aquesta configuració multimodal funcioni en la pràctica. QiliSDK és la capa que permet que un programa es mogui entre CPUs, GPUs i processadors quàntics, amb un back-end basat en CUDA-Q que el connecta a les GPUs.
QiliSDK en poques paraules
QiliSDK és un marc de programació Python de codi obert per desenvolupar, executar i emular algorismes quàntics digitals i analògics, creat per Qilimanjaro. El seu disseny modular abasta la creació de circuits de prototipatge, la construcció de Hamiltonians, el disseny de workflows variables i la definició de models de dipòsits quàntics, i tots ells es poden desplegar en entorns locals o remots.
QiliSDK és el programari que uneix la multimodalitat: el mateix codi d'alt nivell pot dirigir-se a un processador de portàtil, una GPU, un QPU analògic o digital, de manera que el límit entre l'execució clàssica i la quàntica és gestionat pel programari i no per l'usuari.
Backendos
L'emulació en QiliSDK està disponible a través de tres entorns: QiliSim, QutipBackend i CudaqBackend. QiliSim és el simulador de CPU construït per Qilimanjaro. Té gairebé cap cost d’inici de sessió, la qual cosa el fa la opció natural per a circuits petits i iteracions ràpides.
QutipBackend utilitza QuTip, una biblioteca coneguda per simular la dinàmica dels sistemes quàntics oberts. Finalment, CudaqBackend, basat en la tecnologia NVIDIA CUDA-Q i presentat en una post anterior, s'enrotlla amb CUDA-Q i l'utilitza per seleccionar l'objectiu adequat per a la càrrega de treball:
- Vetor estatal emulació en una GPU (fp32 o fp64) o en diverses GPU, amb una CPU de reserva.
- Xarxes de tensors i Estats del producte de matrius (amb truncació de la dimensió de lligam) per a circuits en els quals aquesta possibilitat s'aconsegueix gràcies a l'entramat.
- Dinàmica per a l'evolució analògica directa dels hamiltonians dependents del temps, sense Trotterització.
El CudaqBackend també admet l'emulació amb soroll. Un model de soroll de QiliSDK es converteix en el seu equivalent CUDA-Q, amb canals de flip de bits, flip de fase, depolarització, Kraus i Lindblad que es poden configurar globalment, per tipus de port, per qubit o per parell (port, qubit).
Execució de múltiples GPU
Un emulador de tipus estatal emmagatzema 2ⁿ amplituds complexes per a n qubits, de manera que cada qubit addicional duplica la memòria necessària. En un sol GPU, aquesta memòria és el límit. Amb precisió doble, un estat de 32 qubits ocupa 64 GiB, la quantitat que s'emmagatzema en un sol GPU de 96 GB. Un estat de 33 qubits ocupa 128 GB, però no ho fa.
El CudaqBackend ara pot distribuir el vector d'estat a totes les GPU d'un node, que agrupen la memòria utilitzant quatre GPU NVIDIA RTX PRO 6000 Blackwell, sumant un total de 380 GB de memòria, suficient per a un estat de 34 qubits (256 GiB en doble precisió). El programa QiliSDK no canvia: el mateix circuit funciona en una GPU o en diverses.
Benchmark
Càrrega de treball i maquinari
Els circuits Clifford+T escollits de manera aleatòria van ser 1.000 portes i 100 mostres, amb 4 a 34 qubits. Cada punt és la mitjana de 5 execucions. Es van comparar tres configuracions del QiliSDK 0.3.1: QiliSim en CPU, CUDA-Q 0.16.0.post1 en un sol GPU i CUDA-Q 0.16.0.post1 en quatre GPUs. Tots els execucions van utilitzar la mateixa màquina: un Intel Xeon Platinum 8559C amb 1.024 GB de RAM i quatre GPU NVIDIA RTX PRO 6000 Blackwell Server Edition (96 GB cada un).
					importació de circuits de qilisdk.digital, H, X, Y, Z, CNOT, T
des de qilisdk.backends import CudaqBackend
de qilisdk.functionals import DigitalPropagation
de qilisdk.readout import Readout
# Configuració general
nqubits = 5
nshots = 100
ngates = 1000
# Circuit aleatori
c = Circuit.random(nqubits=nqubits, ngates=ngates, single_qubit_gates=[H, X, Y, Z, T],
two_qubit_gates=[CNOT])
# Configureu tot
func = DigitalPropagation(c)
readout = Readout().with_sampling(nshots=nshots)
backend = CudaqBackend()
# Executar la simulació
res = backend.execute(func, readout)
print(res)
Resultats
La figura 1 mostra el temps d'execució de les tres configuracions de 4 a 34 qubits. Per als circuits petits, cada execució es completa en menys d'un segon. Fins a uns 20 qubits, QiliSim els completa en 13 a 30 ms, mentre que CUDA-Q té una càrrega addicional fixa d'uns 0,35 s per execució que no depèn del nombre de qubits, de manera que en aquestes mides el temps d'execució reflecteix la configuració inicial en lloc de l'emulació.
A mesura que els circuits creixen, l’execució de la GPU pren el protagonisme. El temps de QiliSim es duplica aproximadament amb cada qubit afegit: a 25 qubits triga uns 0,4 s contra els 0,5 s de CUDA-Q, i a 26 qubits la GPU ja està per davant (0,6 s contra 0,9 s). Des d’aquí, la diferència s’amplia amb cada qubit: a 30 qubits la GPU triga uns 4 s contra els 15 s de CPU, i a 32 qubits uns 15 s contra els 62 s (Figura 1).
L'execució de múltiples GPU amplifica la mida accessible. Fins a 32 qubits, les corbes de GPU individual i múltiple de la figura 1 es superposen, de manera que distribuir el vector d'estat entre quatre GPU no implica cap cost notable. Més enllà de 32 qubits, un sol GPU es queda sense memòria, mentre que la configuració de quatre GPU continua fins als qubits 33 i 34, on un procés dura 50 segons, aproximadament 5 vegades més ràpid que amb el processador central.
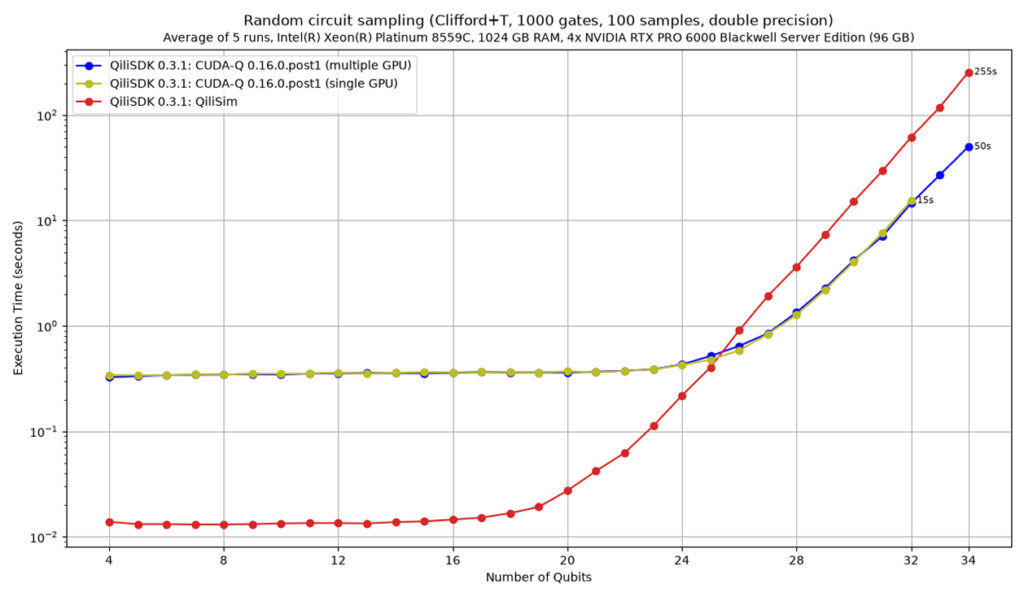
Gràfic 1. Temps d'execució (escala logarítmica) per a la presa de mostres de circuits aleatoris, de 4 a 34 qubits.
Quin backend utilitzar?
Per a càrregues de treball més pesades, des de 33 qubits fins a la memòria del node, la configuració a utilitzar és la de NVIDIA CUDA-Q en múltiples GPUs: la unió de la memòria de cada GPU del node elimina el límit de la memòria d'una sola GPU, i a 34 qubits funciona aproximadament 5 vegades més ràpid que els emuladors de CPU. Entre uns 26 i 32 qubits, una sola GPU és suficient, sent 1,4 a 4 vegades més ràpida que el CPU, amb una acceleració que creix amb cada qubit afegit. Per sota dels 25 qubits, QiliSim en CPU continua sent una opció convenient per a la prototipació ràpida i la iteració.
Conclusió
El suport a múltiples GPU elimina el límit de memòria de GPU individual del backend basat en CUDA-Q de QiliSDK. Una emulació d’estat-vector arriba a 34 qubits en quatre GPUs de 96 GB, sense afectar el rendiment des del límit d’una sola GPU (32 qubits) fins al límit del maquinari analitzat (34 qubits). El mateix programa es carrega en un ordinador portàtil, un GPU individual, un node multi-GPU o en Qilimanjaro Quantum Computers: l’usuari escriu l’algorisme una vegada i el programari tria on s’executa.
Comenceu amb QiliSDK
- Instal·la: pip install qilisdk
- Docs (EN / ES / CA): https://qilimanjaro-tech.github.io/qilisdk/
- Font: https://github.com/qilimanjaro-tech/qilisdk
- Cita: DOI 10.5281/zenodo.20411054